PUWU Insights Library · S
Strony osierocone (orphan pages) – co to jest i jak je znaleźć
 Mateusz Owczarek
- w skrócie
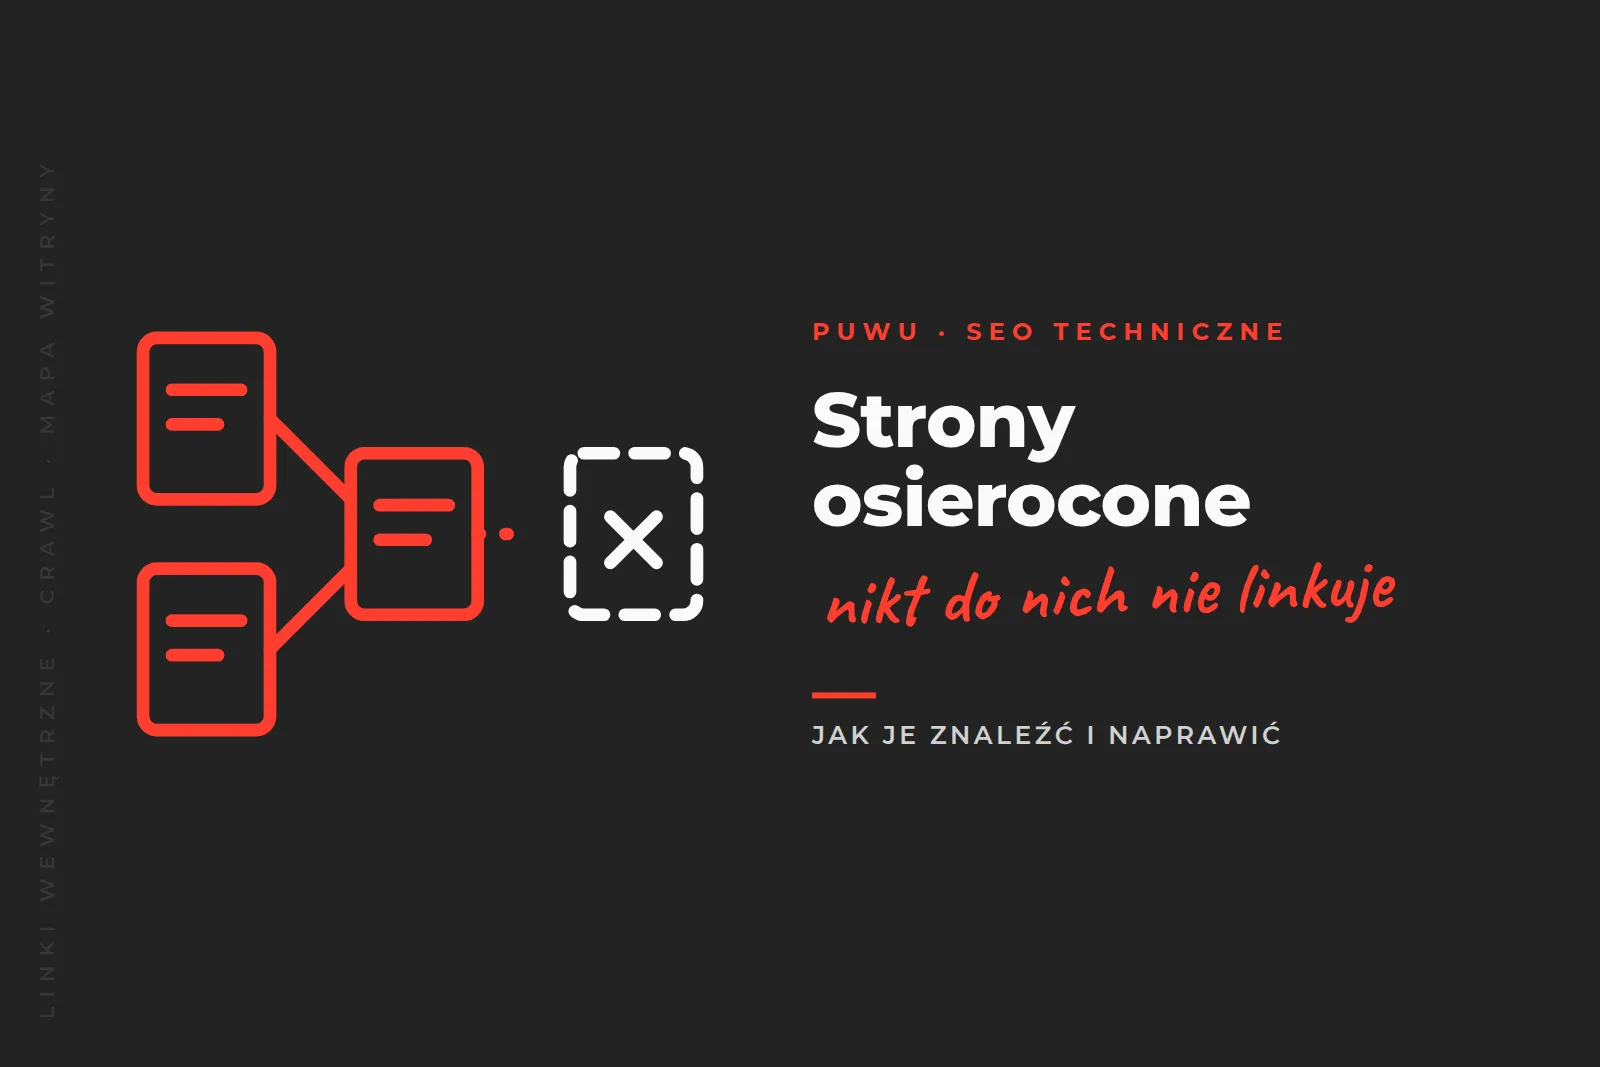
- Strona osierocona (orphan page) to podstrona, do której nie prowadzi żaden link wewnętrzny z innych podstron serwisu. Istnieje i może działać, ale ani użytkownik, ani robot Google nie trafi na nią, klikając po stronie.
W tym haśle wyjaśniamy, czym są strony osierocone, skąd się biorą, dlaczego obniżają widoczność w Google, jak je wyszukać i co zrobić z każdą znalezioną podstroną.
Skąd biorą się strony osierocone
Rzadko ktoś tworzy je celowo. Najczęściej to efekt uboczny zmian w serwisie:
- Migracja albo przebudowa strony – nowe menu nie obejmuje wszystkich starych podstron, a nikt nie sprawdził, czy każda z nich ma jeszcze link z innego miejsca. Więcej o tym ryzyku piszemy w tekście o migracji SEO.
- Zmiana adresu (slugu) – linki w treści dalej wskazują stary adres (często przez przekierowanie), a nowa wersja strony nie ma żadnego bezpośredniego linku.
- Wpisy blogowe bez linkowania – nowy artykuł pojawia się na liście wpisów, ale po kilku tygodniach spada na dalsze strony paginacji i nikt go nie podlinkował z innych tekstów.
- Strony usunięte z menu – np. opis specjalizacji kancelarii, którą przestała eksponować, choć podstrona nadal działa i ma ruch z Google.
- Strony tworzone na chwilę – landing pages pod kampanie, wersje testowe, podstrony wydarzeń.
Dlaczego to problem dla SEO
Google odkrywa nowe podstrony przede wszystkim przez linki. Jego wytyczne mówią wprost, że linki pomagają zarówno znaleźć stronę, jak i ocenić jej znaczenie, a opisowy tekst linku wewnętrznego pomaga zrozumieć, o czym jest strona docelowa. Strona osierocona traci więc kilka rzeczy naraz:
| Co traci strona osierocona | Skutek |
|---|---|
| Ścieżkę dla robota | Google może jej nie odkryć albo odwiedzać rzadko, więc zmiany na stronie długo nie trafiają do wyników. |
| Sygnał ważności | Skoro nawet sam serwis do niej nie linkuje, trudno uznać ją za istotną – zwykle rankuje gorzej, niż pozwalałaby treść. |
| Kontekst z tekstu linków | Google nie dostaje podpowiedzi, na jakie tematy jest strona. |
| Użytkowników | Nikt nie przejdzie do niej z innych podstron – traci ruch i konwersje. |
Na małej stronie problem dotyczy zwykle kilku podstron. W dużych serwisach – sklepach, portalach, blogach z setkami wpisów – może ich być dziesiątki albo setki, a Google sam przyznaje, że w dużych serwisach trudno dopilnować, by do każdej strony prowadził choć jeden link z innej podstrony.
O tym, co dzieje się z podstroną po odkryciu przez robota, przeczytasz w haśle indeksacja.
Strona osierocona to nie to samo co…
- Strona głęboko ukryta – link do niej istnieje, ale trzeba kliknąć pięć czy sześć razy od strony głównej. Robot do niej dotrze, tylko później i rzadziej.
- Strona bez linków wychodzących (ślepa uliczka) – ma linki przychodzące, ale sama nie prowadzi dalej. Problem dla użytkownika, mniejszy dla indeksacji.
- Strona niezaindeksowana – może mieć mnóstwo linków, a mimo to nie być w indeksie (np. przez noindex albo niską jakość). Osierocenie bywa jedną z przyczyn braku indeksacji, ale nie jedyną.
Jak znaleźć strony osierocone
Zasada jest prosta: porównujesz listę adresów, które istnieją, z listą adresów, do których da się dojść po linkach. Wszystko, co jest na pierwszej liście, a nie ma go na drugiej, to kandydaci na strony osierocone.
Skąd wziąć listę istniejących adresów:
- Mapa witryny (sitemap.xml) – w WordPressie generuje ją np. Yoast SEO.
- Google Search Console – raport Skuteczność (strony z wyświetleniami) i raport indeksowania stron.
- Google Analytics 4 – strony, które mają wejścia, np. z kampanii albo z zewnętrznych linków.
- Logi serwera – adresy, które odwiedza Googlebot.
Listę stron osiągalnych po linkach daje crawler, który przechodzi serwis tak jak robot. W Screaming Frog SEO Spider wystarczy włączyć w konfiguracji mapę witryny oraz połączenie z Search Console i Analytics, a po skanowaniu uruchomić Crawl Analysis – w zakładkach Sitemaps, Analytics i Search Console pojawi się filtr Orphan URLs z listą stron, do których nie prowadzi żaden link. Podobne raporty mają audyty w Ahrefs i Semrush.
Na małej stronie wystarczy nawet ręczne porównanie: lista z mapy witryny w jednym arkuszu, lista z crawla w drugim i wyszukanie różnic.
Co zrobić z każdą znalezioną stroną
Nie każdą stronę osieroconą trzeba ratować. Decyzja zależy od tego, czy ma wartość:
| Sytuacja | Co zrobić |
|---|---|
| Strona jest wartościowa i aktualna | Dodaj linki z 2–3 tematycznie powiązanych podstron (najlepiej w treści, z opisowym tekstem linku), a jeśli pasuje – z menu, stopki albo strony filarowej. |
| Strona jest starą wersją innej podstrony lub duplikatem | Ustaw przekierowanie 301 na aktualny odpowiednik – o przekierowaniach piszemy w przewodniku po kodach HTTP. |
| Strona nie ma już wartości | Usuń ją (kod 404 lub 410) i wyrzuć z mapy witryny. |
| Strona jest osierocona celowo (kampania, test) | Zostaw, ale oznacz noindex i nie dodawaj do mapy witryny. |
Jak nie dopuszczać do osierocania
- Każdy nowy tekst od razu linkuj – z co najmniej 2–3 istniejących wpisów lub haseł, a nie tylko z listy na blogu.
- Buduj strukturę tematyczną – model hub & spoke z jedną stroną filarową i powiązanymi z nią tekstami sprawia, że nowe treści mają naturalne miejsce na linki.
- Korzystaj z elementów, które linkują automatycznie – okruszki (breadcrumbs), sekcje „powiązane teksty”, listy kategorii.
- Po każdej migracji i zmianie menu zrób crawl porównawczy – przed i po zmianie.
- Raz na kwartał przejrzyj raport stron osieroconych – zajmuje to kilkanaście minut, a oszczędza miesiące niewykorzystanego potencjału. To stały element naszego pozycjonowania stron.
Źródła
- Google Search Central – „Link best practices for Google”: linki jako sposób odkrywania stron i sygnał ich znaczenia, rola tekstu linku wewnętrznego. developers.google.com
- Google Search Central – „Learn about sitemaps”: kiedy mapa witryny pomaga w odkrywaniu stron i dlaczego w dużych serwisach trudno zapewnić link do każdej podstrony. developers.google.com
- Screaming Frog – „How To Find Orphan Pages”: wyszukiwanie stron osieroconych przez porównanie crawla z mapą witryny, Google Analytics i Search Console. screamingfrog.co.uk
Powiązane pojęcia
Najczęstsze pytania.
Czy strona osierocona może być w Google?
Tak. Google może ją znaleźć w mapie witryny albo przez link z innego serwisu i ją zaindeksować. Bez linków wewnętrznych dostaje jednak słaby sygnał, że jest ważna, więc zwykle rankuje gorzej, niż mogłaby.
Czy wystarczy dodać stronę do mapy witryny (sitemap.xml)?
Nie. Mapa witryny pomaga Google odkryć adres, ale nie zastępuje linków wewnętrznych – nie przekazuje kontekstu ani znaczenia strony i nie prowadzi do niej użytkowników.
Czy landing page pod kampanię Google Ads to strona osierocona?
Technicznie tak, ale to osierocenie celowe i nie jest błędem. Jeśli taka strona nie ma rankować, oznacz ją jako noindex i nie dodawaj do mapy witryny.
Jak często szukać stron osieroconych?
Zawsze po migracji, przebudowie menu albo zmianie adresów, a w aktywnie rozwijanym serwisie – mniej więcej raz na kwartał, przy okazji audytu technicznego.